نویسنده: تیم محتوای امین فرانگر هوشمند
آخرین بهروزرسانی: ۲۷ مهر ۱۴۰۵
سازمانها معمولاً کمبود اطلاعات ندارند؛ مشکل این است که اطلاعات در فایلهای PDF، دستورالعملها، تیکتها، Wiki داخلی، قراردادها و پایگاههای داده پراکنده است. کارمند برای یافتن یک پاسخ باید چند سامانه را جستوجو کند و باز هم مطمئن نیست آخرین نسخه سند را دیده باشد. اتصال مستقیم یک مدل زبانی به این دانش نیز ساده نیست: مدل ممکن است اطلاعات اختصاصی سازمان را نداند، پاسخ بدون مدرک بسازد یا محتوایی را نشان دهد که کاربر اجازه دیدن آن را ندارد.
پاسخ کوتاه: RAG یا Retrieval-Augmented Generation روشی است که پیش از تولید پاسخ، اطلاعات مرتبط را از منابع مورداعتماد بازیابی و به مدل زبانی ارائه میکند. در یک دستیار سازمانی، RAG میتواند پاسخ را بر پایه اسناد داخلی، همراه با منبع و سطح دسترسی کاربر بسازد. کیفیت آن به آمادهسازی دانش، جستوجو، امنیت و ارزیابی مداوم وابسته است.
RAG چیست؟
RAG مخفف Retrieval-Augmented Generation و به معنی «تولید تقویتشده با بازیابی» است. این الگو جستوجوی اطلاعات را با توانایی تولید متن در مدلهای زبانی بزرگ یا LLM ترکیب میکند. بهجای اینکه مدل فقط به دانشی متکی باشد که هنگام آموزش در پارامترهایش ذخیره شده، ابتدا چند بخش مرتبط از یک منبع بیرونی پیدا میشود؛ سپس پرسش کاربر و محتوای بازیابیشده در یک Prompt کنترلشده به مدل داده میشوند.
مقاله پژوهشی RAG در سال ۲۰۲۰ این ایده را بهعنوان ترکیب حافظه پارامتری مدل با حافظه غیرپارامتری و قابل جستوجو صورتبندی کرد. در کاربرد سازمانی امروز، حافظه بیرونی میتواند شامل سیاستهای منابع انسانی، راهنمای محصول، مستندات فنی، دانش پشتیبانی، آییننامهها یا رکوردهایی باشد که از سامانههای مجاز دریافت میشوند.
RAG یک مدل مستقل نیست و الزاماً به Vector Database محدود نمیشود. این الگو از چند جزء تشکیل میشود: آمادهسازی داده، نمایهسازی، Retrieval، انتخاب Context، تولید پاسخ و ارزیابی. بسته به نوع داده، جستوجوی واژهای، معنایی، Hybrid Search، فیلتر Metadata یا Query مستقیم به پایگاه داده میتواند بخشی از آن باشد.
هدف RAG این نیست که مدل «همهچیز را بداند». هدف این است که برای هر سؤال، شواهد مرتبط و مجاز را در زمان مناسب پیدا کند و پاسخ را به همان شواهد متصل نگه دارد.
RAG چه مسئلهای را در سازمان حل میکند؟
دسترسی به دانش اختصاصی
مدل عمومی از فرایند تأیید سفارش، نامگذاری داخلی محصول یا نسخه تازه سیاست سازمان خبر ندارد. RAG اجازه میدهد این اطلاعات بدون آموزش دوباره مدل در دسترس پاسخگویی قرار گیرند. با بهروزرسانی سند و نمایه، دانش قابل بازیابی نیز تغییر میکند.
ارائه منبع و قابلیت بررسی
اگر سیستم شناسه سند، عنوان، نسخه و محل Passage را همراه نتیجه نگه دارد، میتواند کنار پاسخ لینک منبع نشان دهد. این قابلیت به کاربر امکان میدهد متن اصلی را بررسی کند. Citation کیفیت پاسخ را تضمین نمیکند، اما بررسی و کشف خطا را آسانتر میسازد.
کاهش پاسخهای بدون پشتوانه
وقتی Prompt مدل را ملزم کند فقط بر اساس Context پاسخ دهد و در نبود شواهد اعلام کند «اطلاعات کافی پیدا نشد»، احتمال پاسخ ساختگی کمتر میشود. بااینحال RAG توهم مدل را حذف نمیکند؛ سند نامرتبط، Chunk ناقص یا تفسیر غلط هنوز میتواند پاسخ ضعیف بسازد.
جستوجوی مکالمهای
کاربر لازم نیست بداند سند در کدام پوشه است یا عبارت دقیق آن چیست. میتواند سؤال را با زبان طبیعی مطرح کند، سؤال تکمیلی بپرسد و به منبع برسد. این مزیت، RAG را برای دستیار دانش سازمانی و چتبات هوش مصنوعی برای سایت و فروش جذاب میکند؛ البته منابع، هدف و مرز پاسخگویی در این دو سناریو متفاوتاند.
RAG چگونه کار میکند؟
۱. اتصال به منابع دانش
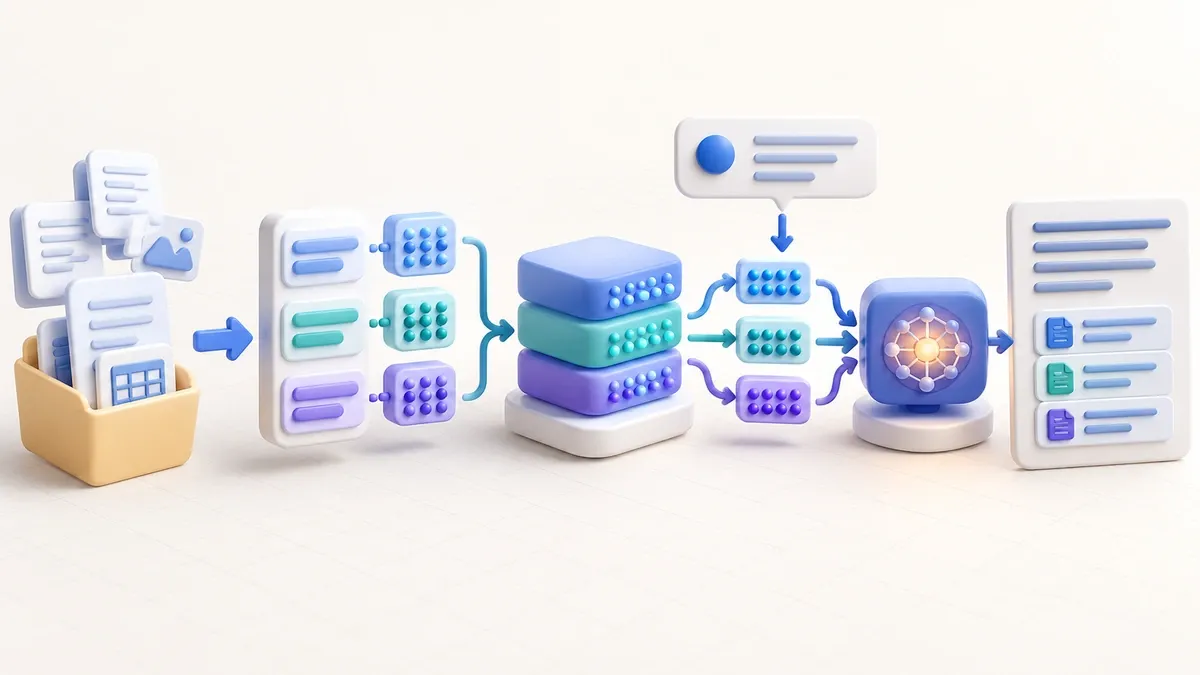
ابتدا منابع مجاز شناسایی میشوند: SharePoint، Google Drive، Wiki، سامانه تیکت، CRM، فایلسرور یا APIهای داخلی. برای هر منبع باید مالک محتوا، سطح محرمانگی، تناوب تغییر و وضعیت نسخه مشخص باشد. «هر فایلی که پیدا شد» استراتژی مناسبی نیست؛ اسناد منقضی، تکراری و فاقد مالک کیفیت Retrieval را پایین میآورند.
۲. پاکسازی و تقسیم سند
سند استخراجشده به بخشهای کوچکتر یا Chunk تقسیم میشود. Chunk بسیار کوتاه زمینه کافی ندارد و Chunk بسیار بلند ممکن است چند موضوع نامرتبط را مخلوط کند. مرز عنوان، پاراگراف، جدول و فصل معمولاً از بریدن مکانیکی بر اساس تعداد نویسه مفیدتر است. Metadataهایی مانند عنوان، واحد سازمانی، تاریخ اعتبار، زبان و ACL باید کنار هر Chunk نگهداری شوند.
۳. ساخت Embedding و نمایه
Embedding یک نمایش عددی از معنای متن است. بردار پرسش با بردار Chunkها مقایسه میشود تا بخشهای نزدیک از نظر معنا پیدا شوند. برای عبارت دقیق، شماره قرارداد یا نام محصول، جستوجوی واژهای همچنان مهم است؛ به همین دلیل Hybrid Search که نتایج واژهای و برداری را ترکیب میکند، در بسیاری از پروژهها عملکرد بهتری دارد.
۴. دریافت سؤال و اعمال دسترسی
هویت کاربر و مجوزهای او باید پیش از بازیابی وارد Query شوند. سیستم نباید ابتدا محتوای محرمانه را بازیابی کند و بعد امیدوار باشد مدل آن را نمایش ندهد. فیلتر مبتنی بر ACL، Tenant، واحد سازمانی و نوع سند باید در لایه Retrieval یا منبع داده اجرا شود.
۵. بازیابی و Reranking
Retriever چند Candidate پیدا میکند. سپس Reranker میتواند ترتیب نتایج را با توجه دقیقتر به سؤال اصلاح کند. تعداد نتایج باید کنترل شود: Context بیشتر الزاماً بهتر نیست و ممکن است اطلاعات متناقض یا کماهمیت را وارد Prompt کند.
۶. ساخت Prompt و تولید پاسخ
Prompt شامل نقش دستیار، سؤال، Contextهای منتخب، قواعد Citation و رفتار در نبود اطلاعات است. مدل باید تفاوت میان دستور سیستم و متن سند را بشناسد؛ زیرا خود سند ممکن است جملهای شبیه دستور داشته باشد. خروجی مناسب معمولاً پاسخ کوتاه، محدودیتها و فهرست منابع را شامل میشود.
۷. ثبت بازخورد و ارزیابی
سؤال، اسناد بازیابیشده، پاسخ، زمان اجرا و بازخورد کاربر باید با رعایت Privacy ثبت شوند. این دادهها برای پیدا کردن Queryهای بدون پاسخ، اسناد گمشده و خطاهای دسترسی استفاده میشوند. بدون Evaluation، تیم فقط کیفیت چند Demo را میبیند و از رفتار واقعی سیستم خبر ندارد.
اجزای معماری یک دستیار هوشمند سازمانی
| لایه | وظیفه | ریسک مهم |
|---|---|---|
| منابع دانش | تأمین محتوای معتبر و بهروز | سند منقضی یا بدون مالک |
| Ingestion | استخراج، پاکسازی، Chunking و Metadata | ازبینرفتن ساختار جدول یا عنوان |
| Index و Search | جستوجوی واژهای، برداری و فیلترها | بازیابی نامرتبط یا افشای داده |
| Orchestration | بازنویسی Query، Reranking و ساخت Context | Context طولانی یا متناقض |
| LLM | درک سؤال و تولید پاسخ | استنتاج فراتر از شواهد |
| رابط کاربر | گفتوگو، نمایش منبع و دریافت بازخورد | اعتماد بیشازحد کاربر |
| امنیت و مشاهدهپذیری | ACL، Audit Log، Monitoring و سیاست نگهداری | ثبت داده حساس یا نبود ردپا |
| Evaluation | اندازهگیری Retrieval و Answer Quality | تکیه بر قضاوت موردی |
تفاوت RAG با Fine-tuning چیست؟
RAG و Fine-tuning رقیب مستقیم نیستند. Fine-tuning رفتار، لحن، قالب خروجی یا توانایی انجام یک وظیفه را با نمونههای آموزشی تغییر میدهد. برای افزودن یک فایل سیاستگذاری که هفته بعد عوض میشود، Fine-tuning معمولاً راه مناسبی نیست؛ چون دانش در وزنهای مدل قرار میگیرد، بهروزرسانی آن دشوارتر است و منبع پاسخ بهسادگی قابل نمایش نیست.
RAG اطلاعات را هنگام درخواست بازیابی میکند و برای دانش متغیر یا اختصاصی مناسب است. گاهی هر دو با هم استفاده میشوند: یک مدل برای قالب پاسخ یا طبقهبندی تخصصی Fine-tune میشود و RAG شواهد تازه را تأمین میکند. انتخاب باید از خطای موردنظر شروع شود، نه از نام فناوری.
RAG با جستوجوی ساده چه تفاوتی دارد؟
جستوجو فهرستی از اسناد یا بخشهای مرتبط ارائه میکند. RAG علاوه بر Retrieval، آن بخشها را برای ساخت پاسخ ترکیب و خلاصه میکند. این کار تعامل را سادهتر میسازد، اما یک ریسک تازه هم اضافه میکند: مدل ممکن است بین چند منبع رابطهای بسازد که در متن وجود ندارد.
در موضوعات حساس، نمایش Passage اصلی یا حتی ارائه نتیجه جستوجو بهجای پاسخ قطعی میتواند مناسبتر باشد. طراحی حرفهای همیشه نیاز به «جواب کامل» ندارد؛ گاهی پاسخ کوتاه همراه با لینک و هشدار کافی است.
مثال عملی: دستیار دانش تیم پشتیبانی
فرض کنید تیم پشتیبانی یک نرمافزار B2B با صدها راهنما، Release Note و تیکت حلشده کار میکند. کارشناس تازهوارد میپرسد: «اگر همگامسازی سفارش بعد از ارتقا متوقف شد، چه مراحلی را بررسی کنم؟»
سیستم ابتدا هویت کارشناس و محصول مجاز را تشخیص میدهد. Query را با نام نسخه و ماژول غنی میکند، در راهنماهای فنی و تیکتهای تأییدشده جستوجو میکند و نتایج منقضی را با Metadata کنار میگذارد. Reranker سه Passage مرتبط را انتخاب میکند. مدل مراحل بررسی را به ترتیب مینویسد و کنار هر مرحله منبع و نسخه سند را نشان میدهد. اگر اسناد درباره نسخه فعلی تعارض داشته باشند، سیستم بهجای جمعبندی قطعی، تعارض را اعلام و Escalation پیشنهاد میکند.
ارزش این دستیار فقط کاهش زمان جستوجو نیست. سؤالهای بدون پاسخ نشان میدهند کدام بخش از مستندات ناقص است. بازخورد کارشناسان نیز به تیم دانش کمک میکند سندهای ضعیف را اصلاح کند. این چرخه، RAG را از یک Chatbot نمایشی به زیرساخت مدیریت دانش تبدیل میکند.
موارد استفاده RAG در کسبوکار
- پاسخگویی کارکنان درباره آییننامهها و فرایندهای داخلی
- جستوجوی مکالمهای در مستندات محصول و دانش فنی
- پیشنهاد پاسخ به کارشناس پشتیبانی همراه با Citation
- دستیار فروش برای یافتن مشخصات محصول و شرایط قرارداد مجاز
- خلاصهسازی پرونده یا تیکت با پیوند به رکوردهای منبع
- دستیار Onboarding برای نقشها و واحدهای مختلف
- تحلیل مجموعه اسناد با امکان Drill-down به متن اصلی
اگر هدف، افزودن تجربه هوش مصنوعی به یک محصول یا پورتال موجود است، راهنمای چگونه هوش مصنوعی را به سایت اضافه کنیم ملاحظات محصول، معماری و تجربه کاربر را کامل میکند.
امنیت و حریم خصوصی در RAG
RAG داده سازمان را به زنجیرهای از Connector، Index، Log و مدل وارد میکند؛ بنابراین امنیت فقط انتخاب مدل نیست. محل ذخیره Embeddingها، رمزنگاری، قرارداد نگهداری داده، Region، Backup و حذف سند باید مشخص شوند. Embedding را نباید خودبهخود «بیخطر» فرض کرد؛ دسترسی به Index و Metadata باید مانند داده اصلی کنترل شود.
Prompt Injection نیز ریسک مهمی است. یک سند آلوده ممکن است از مدل بخواهد قواعد سیستم را نادیده بگیرد. جداکردن دستور از داده، محدودکردن Toolها، اعتبارسنجی خروجی و علامتگذاری محتوای غیرقابلاعتماد بخشی از دفاع است. مقاله امنیت و حریم خصوصی در پروژههای هوش مصنوعی این کنترلها را با جزئیات بیشتری بررسی میکند.
اصل حداقل دسترسی باید در تمام مسیر رعایت شود. کاربر فقط باید Chunkهایی را ببیند که در منبع اصلی نیز اجازه مشاهده آنها را دارد. Audit Log باید نشان دهد چه کسی چه پرسشی مطرح کرد، چه اسنادی بازیابی شدند و کدام نسخه سیستم پاسخ داد؛ در عین حال خود Log نباید داده حساس غیرضروری را ذخیره کند.
چگونه کیفیت RAG را اندازهگیری کنیم؟
ارزیابی را به دو بخش تقسیم کنید. Retrieval Quality میسنجد آیا شواهد لازم در نتایج اولیه آمدهاند. معیارهایی مانند Recall@K، Precision@K و رتبه Passage مرتبط مفیدند. Answer Quality بررسی میکند پاسخ با سؤال مرتبط، بر شواهد استوار، کامل و دارای Citation صحیح است یا نه.
یک مجموعه آزمون واقعی از سؤالهای آسان، مبهم، چندمرحلهای، بدون پاسخ و دارای محدودیت دسترسی بسازید. برای هر سؤال، شواهد مورد انتظار و رفتار مطلوب را تعریف کنید. سپس تغییر Chunking، Embedding، Hybrid Search، Reranker و Prompt را جداگانه آزمایش کنید. تغییر همزمان همه اجزا، علت بهبود یا افت را پنهان میکند.
در محیط عملیاتی نیز نرخ «اطلاعات کافی نیست»، کلیک روی منبع، بازخورد کاربر، Latency، هزینه هر پاسخ و رخدادهای امنیتی را دنبال کنید. ROI باید با زمان صرفهجوییشده، کاهش Escalation و بهبود کیفیت کار سنجیده شود، نه فقط تعداد گفتوگوها. مقاله محاسبه ROI پروژه هوش مصنوعی و اتوماسیون برای طراحی این سنجش مفید است.
اشتباههای رایج در ساخت RAG
نمایهکردن همه اسناد بدون حاکمیت محتوا
سند تکراری و منقضی باعث تعارض میشود. پیش از Ingestion، مالک، نسخه معتبر و سیاست حذف تعیین کنید.
بهینهسازی فقط Prompt
اگر Passage درست بازیابی نشده باشد، بهترین Prompt نیز شواهد لازم را ندارد. ابتدا خطای Retrieval و سپس خطای Generation را جدا کنید.
تکیه کامل بر Vector Search
کد، شماره، نام خاص و عبارت حقوقی ممکن است با Keyword Search بهتر پیدا شوند. Hybrid Retrieval و Metadata Filter را آزمایش کنید.
نادیدهگرفتن سؤال بدون پاسخ
دستیار باید بتواند توقف کند، محدودیت را بگوید و مسیر ارجاع ارائه دهد. پاسخدادن اجباری اعتماد را از بین میبرد.
انتشار بدون Golden Dataset
دموی جذاب جای ارزیابی سیستماتیک را نمیگیرد. مجموعه آزمون باید پیش از Pilot آماده شود و با سؤالهای واقعی رشد کند.
نقشه راه ساخت دستیار هوشمند سازمانی
- یک مسئله محدود انتخاب کنید: یک واحد، یک نوع سند و چند سناریوی پرتکرار.
- مالک دانش را تعیین کنید: مسئول اعتبار، نسخه و حذف محتوا باید مشخص باشد.
- مدل تهدید بنویسید: سطح دسترسی، داده حساس، Prompt Injection و Log را بررسی کنید.
- Baseline جستوجو بسازید: قبل از Generation مطمئن شوید Retrieval شواهد درست را پیدا میکند.
- Prototype انتهابهانتها ایجاد کنید: Citation، پاسخ بدون مدرک و Escalation را از ابتدا طراحی کنید.
- Golden Dataset تهیه کنید: سؤال، پاسخ مورد انتظار، سند مرجع و سطح دسترسی را ثبت کنید.
- Pilot کنترلشده اجرا کنید: گروه کوچکی از کاربران واقعی را وارد چرخه بازخورد کنید.
- عملیات را آماده کنید: Monitoring، هزینه، Refresh Index، Incident Response و Rollback تعریف شوند.
RAG، Agent یا Chatbot؟
RAG الگوی دسترسی به دانش است. Chatbot شکل تعامل مکالمهای است. Agent علاوه بر پاسخگویی میتواند برای رسیدن به هدف، ابزار انتخاب کند و اقدام انجام دهد. یک Chatbot میتواند بدون RAG باشد؛ یک دستیار RAG ممکن است رابط Chat نداشته باشد؛ و یک Agent میتواند برای کسب دانش از RAG استفاده کند.
اگر سیستم باید سفارش را تغییر دهد، تیکت بسازد یا Workflow اجرا کند، ریسک از «پاسخ اشتباه» به «اقدام اشتباه» گسترش مییابد. تأیید انسانی، محدودیت Tool و کنترل تراکنش ضروری میشود. مقاله تفاوت AI Agent، Chatbot و Workflow Automation مرز این انتخابها را روشنتر میکند.
جمعبندی
RAG راهی برای متصلکردن مدل زبانی به دانش بیرونی، تازه و قابل استناد است. اما یک دستیار سازمانی موفق فقط از LLM و Vector Database ساخته نمیشود. کیفیت محتوا، Metadata، Retrieval، دسترسی، Citation، ارزیابی و عملیات روزمره به یک اندازه مهماند.
بهترین شروع، یک پایلوت کوچک با سؤالهای واقعی و اسناد تحت کنترل است. ابتدا نشان دهید سیستم شواهد درست را با مجوز درست پیدا میکند؛ سپس کیفیت پاسخ، تجربه کاربر و صرفه اقتصادی را توسعه دهید.
برای ارزیابی منابع دانش، طراحی معماری امن و ساخت پایلوت، صفحه خدمات هوش مصنوعی و اتوماسیون را ببینید. نقطه شروع مناسب، یک مسئله محدود و قابل اندازهگیری است.