نویسنده: تیم محتوای امین فرانگر هوشمند
آخرین بهروزرسانی: ۲۷ مهر ۱۴۰۵
ممکن است سایت شرکتی محتوای تخصصی، طراحی حرفهای و حتی بکلینک مناسب داشته باشد، اما بخشی از صفحات مهم آن در نتایج گوگل دیده نشوند. گاهی ربات جستوجو به صفحه دسترسی ندارد، نسخه اشتباهی بهعنوان Canonical انتخاب شده، محتوای JavaScript پس از Render ناقص است یا هزاران URL فیلترشده بودجه خزش را مصرف میکنند. سئوی فنی برای کشف و اصلاح همین موانع زیرساختی است؛ موانعی که با تولید محتوای بیشتر لزوماً حل نمیشوند.
پاسخ کوتاه: سئوی فنی یا Technical SEO مجموعه اقدامهایی است که دسترسی رباتها، Crawl، Render، Index و درک ساختار سایت را بهبود میدهد. ممیزی فنی وضعیت robots.txt، Sitemap، Status Code، Redirect، Canonical، معماری لینک، موبایل، JavaScript، Core Web Vitals، Schema و امنیت را بررسی و خطاها را بر اساس اثر بر صفحات تجاری اولویتبندی میکند.
سئوی فنی چیست؟
سئوی فنی بخشی از SEO است که کمک میکند موتور جستوجو بتواند URLهای درست را کشف کند، محتوای اصلی را ببیند، نسخه مناسب را در Index نگه دارد و رابطه صفحات را بفهمد. این کار از تنظیمات سرور و CMS تا HTML، JavaScript، معماری اطلاعات و Performance را در بر میگیرد.
Technical SEO تضمین رتبه نیست. گوگل نیز در راهنمای رسمی خود تأکید میکند رازی برای رتبه اول وجود ندارد. حتی اگر صفحه کاملاً قابل Crawl و Index باشد، کیفیت محتوا، تناسب با Query، اعتبار، رقابت و تجربه کاربر همچنان مهماند. نقش سئوی فنی برداشتن مانع و یکپارچهکردن سیگنالهاست؛ نه جایگزینکردن استراتژی محتوا.
مرز فنی و محتوایی همیشه سخت نیست. Title، Heading، لینک داخلی و Alt هم در HTML پیاده میشوند و هم بر فهم محتوا اثر دارند. برای دیدن تصویر کامل مسیر SEO، مقاله سئو از کجا شروع میشود؟ ترتیب تحقیق، ساختار، محتوا و سنجش را توضیح میدهد.
یک ممیزی فنی خوب از «چند خطا پیدا شد» شروع نمیکند؛ از این سؤال شروع میکند که کدام صفحات برای کسبوکار مهماند و چه مانعی جلوی کشف، ایندکس یا عملکرد آنها را گرفته است.
گوگل چگونه یک صفحه را پردازش میکند؟
برای تشخیص خطا باید چهار مرحله را از هم جدا کنیم:
- Discovery و Crawl: گوگل URL را از لینک، Sitemap یا منبع دیگر پیدا و محتوای آن را درخواست میکند. robots.txt، پاسخ سرور و لینکپذیری بر این مرحله اثر دارند.
- Render: برای صفحات وابسته به JavaScript، HTML اولیه و منابع لازم اجرا میشوند تا نسخه Renderشده شکل بگیرد. مسدودبودن فایل یا خطای Client-side میتواند محتوا را پنهان کند.
- Index: محتوا، Metadata و سیگنالهای Canonical بررسی میشوند. Crawlشدن مساوی Indexشدن نیست و Sitemap نیز دستور قطعی ایندکس نیست.
- Serving و Ranking: در پاسخ به Query، سیستمهای رتبهبندی از میان صفحات ایندکسشده نتیجه مناسب را انتخاب میکنند. این مرحله فراتر از تنظیم فنی است.
این تفکیک جلوی تشخیص اشتباه را میگیرد. اگر URL اصلاً Crawl نشده، تغییر متن صفحه مشکل را حل نمیکند. اگر Google-selected canonical به URL دیگری اشاره دارد، باید سیگنالهای نسخهها را بررسی کرد، نه اینکه مرتب Request Indexing زد.
چکلیست سریع ممیزی Technical SEO
| حوزه | کنترل اصلی | خطر رایج |
|---|---|---|
| Crawl | robots.txt، لینکهای قابل Crawl و Log سرور | مسدودشدن صفحه یا Crawl Space بینهایت |
| Index | robots meta، X-Robots-Tag و گزارش Indexing | noindex ناخواسته یا Soft 404 |
| Status Code | 200، 3xx، 4xx و 5xx واقعی | Redirect Chain و صفحه خطا با کد 200 |
| Canonical | همسویی Canonical، Redirect، لینک و Sitemap | Canonical متناقض یا اشاره به صفحه نامرتبط |
| Sitemap | فقط URLهای Canonical و Indexable | وجود Redirect، 404 یا noindex در Sitemap |
| Architecture | عمق کلیک، Orphan Page و Anchor | صفحه مهم بدون لینک داخلی |
| JavaScript | HTML اولیه و Rendered HTML | محتوا و لینک وابسته به اجرای ناقص |
| Mobile | برابری محتوا، Metadata و لینکها | نسخه موبایل ناقص |
| Performance | LCP، INP و CLS با Field Data | بهینهسازی Lab بدون اثر واقعی |
| Structured Data | نوع پشتیبانیشده و تطابق با صفحه | Markup نادرست یا محتوای نامرئی |
| Security | HTTPS، Mixed Content و Security Issues | هک، Spam Injection یا گواهی نامعتبر |
| Monitoring | Search Console، Analytics و Alert | کشف دیرهنگام افت و خطا |
فرایند ممیزی فنی سئو مرحلهبهمرحله
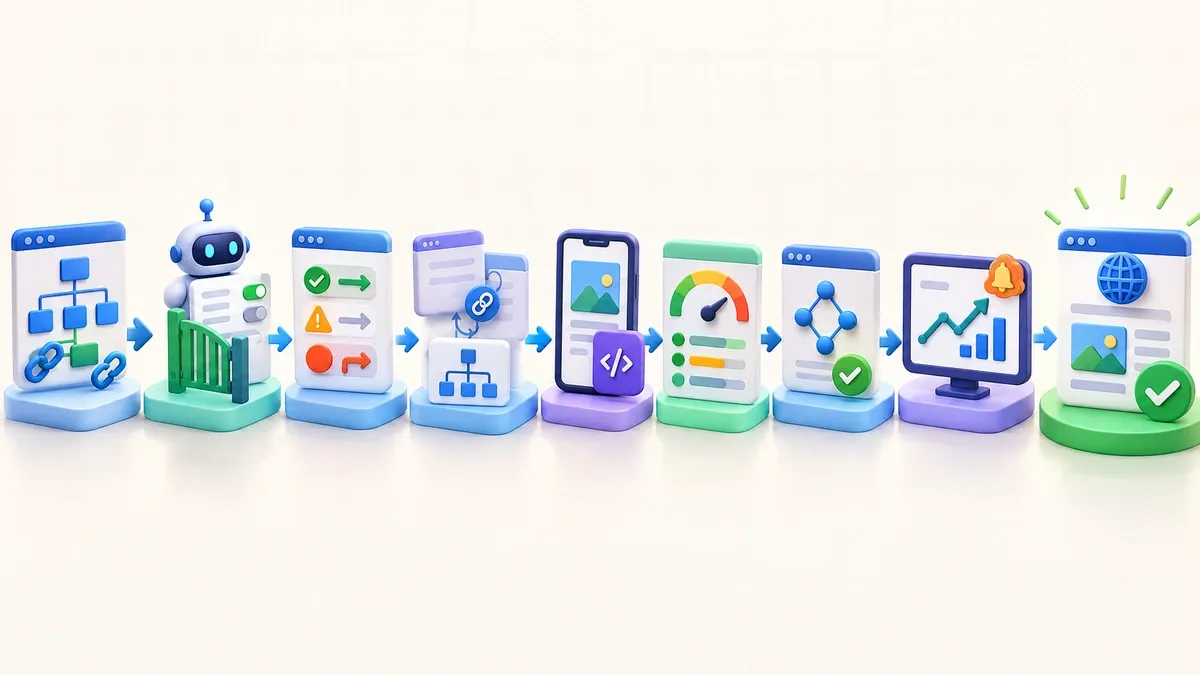
۱. Baseline و دامنه ممیزی را مشخص کنید
ابتدا Propertyهای درست Search Console، Analytics، محیط Production، دامنهها و Subdomainها را فهرست کنید. صفحات درآمدزا، خدمات، تماس، شعب، مقالههای Pillar و Landingهای کمپین را بهعنوان URLهای نمونه انتخاب کنید. قبل از Crawl کامل، افت Click و Impression، تغییر Coverage، Manual Action و Security Issue را مرور کنید.
دامنه Audit باید روشن باشد: کل سایت، مهاجرت، افت ناگهانی، قالب تازه یا یک Subdirectory. Crawl چندصدهزار URL بدون سؤال مشخص ممکن است داده زیاد و تصمیم کم تولید کند.
۲. دسترسی Crawl و robots.txt را بررسی کنید
robots.txt ابزار مدیریت دسترسی Crawler است، نه روش مطمئن حذف URL از نتایج. اگر صفحه Disallow باشد، ربات محتوای آن را نمیخواند؛ با این حال خود URL ممکن است از طریق لینکهای دیگر شناخته و بدون Snippet در نتایج دیده شود. برای خارجکردن صفحه قابل دسترس از Index از noindex استفاده میشود و برای محتوای خصوصی، Authentication راه مناسبتری است.
قواعد باید در Host، Protocol و Port درست قرار گرفته باشند. فایل CSS یا JavaScript ضروری برای Render را بیدلیل مسدود نکنید. پارامترها، جستوجوی داخلی، Calendar و Faceted Navigation را فقط پس از شناخت اثر آنها محدود کنید؛ یک Disallow گسترده میتواند بخش مهمی از سایت را ناپدید کند.
۳. Status Code و Redirectها را تست کنید
صفحه سالم معمولاً 200 میدهد؛ حذف دائمی باید 404 یا 410 واقعی داشته باشد و انتقال URL با Redirect سمت سرور انجام شود. صفحهای که پیام «یافت نشد» دارد اما 200 برمیگرداند Soft 404 است. خطاهای 5xx، Timeout و DNS نیز دسترسی ربات و کاربر را مختل میکنند.
Redirect Chain را کوتاه کنید و Loop را حذف کنید. لینک داخلی و Sitemap باید مستقیماً به مقصد نهایی اشاره کنند. هنگام تغییر دامنه یا ساختار URL، Mapping یکبهیک بسازید؛ Redirect همه صفحات قدیمی به صفحه اصلی، جایگزین مناسبی برای مقصد مرتبط نیست.
۴. Indexing Directiveها را ممیزی کنید
robots meta در HTML و X-Robots-Tag در Header میتوانند noindex، nofollow یا محدودیت Snippet تعیین کنند. برای PDF و فایل غیر HTML، X-Robots-Tag مفید است. توجه کنید Crawler باید اجازه دسترسی به صفحه را داشته باشد تا noindex را ببیند؛ ترکیب Disallow و noindex ممکن است نتیجه مورد انتظار را ندهد.
Template، Staging Setting و تنظیمات CMS را بررسی کنید. یکی از خطاهای پرهزینه، باقیماندن noindex پس از انتشار نسخه جدید است. همچنین صفحهای که قرار است Index شود باید محتوای واقعی، پاسخ 200 و Canonical سازگار داشته باشد.
۵. Canonical و محتوای تکراری را هماهنگ کنید
Canonicalization فرایند انتخاب URL نماینده از میان نسخههای مشابه است. Redirect و rel="canonical" سیگنال قوی و حضور در Sitemap سیگنال ضعیفتری است؛ گوگل ممکن است بر اساس مجموعه سیگنالها URL دیگری انتخاب کند. Canonical «دستور قطعی» نیست.
در سایت شرکتی، نسخههای HTTP/HTTPS، www/non-www، Slash، پارامترهای UTM، چاپ، Sorting و URLهای کمپین میتوانند Duplicate بسازند. Canonical، لینک داخلی، Sitemap و Redirect باید مقصد یکسانی را پیشنهاد دهند. robots.txt ابزار Canonicalization نیست و نباید نسخه Duplicate را طوری مسدود کرد که ربات نتواند رابطه آن را ببیند.
۶. XML Sitemap را پاکسازی کنید
Sitemap فهرست URLهایی است که ترجیح میدهید در نتایج دیده شوند. فقط URLهای Canonical، قابل Crawl، Indexable و دارای پاسخ موفق را وارد کنید. ترتیب URLها اهمیتی ندارد. lastmod را فقط زمانی تغییر دهید که محتوای اصلی واقعاً بهروزرسانی شده باشد.
وجود URL در Sitemap تضمین Crawl یا Index نیست. گزارش هر Sitemap را در Search Console بررسی کنید و اختلاف میان «Submitted» و «Indexed» را با نمونهبرداری تحلیل کنید. برای سایت بزرگ، Sitemap را بر اساس نوع صفحه تقسیم کنید تا تشخیص الگو آسانتر شود.
۷. معماری سایت و لینک داخلی را ارزیابی کنید
صفحات مهم باید از Navigation، Hub یا محتوای مرتبط با لینک HTML استاندارد قابل دسترسی باشند. Orphan Page ممکن است فقط در Sitemap باشد و هیچ مسیر معنایی از سایت نداشته باشد. عمق کلیک زیاد نیز کشف و اهمیت نسبی صفحه را کاهش میدهد.
Anchor Text باید مقصد را توصیف کند و لینکهای شکسته اصلاح شوند. Breadcrumb و ساختار دستهبندی میتوانند رابطه صفحات را روشن کنند. لینکسازی داخلی را بر اساس Journey و Topic Cluster طراحی کنید، نه تکرار مکانیکی یک Keyword.
۸. JavaScript و Render را کنترل کنید
گوگل برنامه JavaScript را Crawl، سپس Render و بعد Index میکند. اگر HTML اولیه فقط App Shell باشد، محتوای اصلی و لینکها به اجرای موفق Script وابستهاند. URL Inspection، Rendered HTML و Network Error کمک میکنند تفاوت نسخه اولیه و نهایی را ببینید.
برای محتوای مهم، Server-side Rendering یا Pre-rendering میتواند سرعت و قابلیت دسترسی را بهبود دهد. لینک باید href قابل Crawl داشته باشد، نه فقط Event کلیک. Status Code، Title، Canonical و robots directive بهتر است در پاسخ اولیه درست باشند و پس از Hydration به مقدار متناقض تغییر نکنند.
۹. Mobile-first و برابری نسخهها را بررسی کنید
محتوا، Heading، لینک، Alt، Structured Data و Metadata مهم نباید در موبایل حذف شوند. طراحی Responsive معمولاً مدیریت نسخهها را ساده میکند، اما وجود آن بهتنهایی کیفیت موبایل را تضمین نمیکند. منو، Lazy Loading، Tab و Infinite Scroll را روی دستگاه و Viewport واقعی آزمایش کنید.
۱۰. Core Web Vitals را با Field Data بسنجید
LCP عملکرد بارگذاری، INP پاسخگویی تعامل و CLS ثبات بصری را میسنجد. هدفهای توصیهشده گوگل بهترتیب ۲.۵ ثانیه یا کمتر، ۲۰۰ میلیثانیه یا کمتر و ۰.۱ یا کمتر در صدک ۷۵ هستند. اما عبور از این آستانهها تضمین رتبه نیست و کیفیت محتوا را جبران نمیکند.
گزارش Search Console و CrUX رفتار کاربران واقعی را نشان میدهند؛ Lighthouse و ابزار Lab برای تشخیص قبل از انتشار مفیدند. صفحهها را بر اساس Template و Device گروهبندی کنید و بهجای بهینهسازی یک URL نمایشی، مشکل مشترک قالب را رفع کنید. مقاله آینده Core Web Vitals؛ ارتباط سرعت، سئو و فروش این موضوع را عمیقتر بررسی میکند.
۱۱. Structured Data را اعتبارسنجی کنید
Schema سرنخ صریحی درباره معنی محتوا میدهد و ممکن است صفحه را برای Rich Result واجد شرایط کند؛ نمایش Rich Result تضمینشده نیست. فقط نوع پشتیبانیشده و مرتبط را استفاده کنید، Propertyهای الزامی را کامل کنید و داده Markup باید با محتوای قابل مشاهده صفحه منطبق باشد.
JSON-LD معمولاً نگهداری سادهتری دارد. Rich Results Test و گزارشهای Search Console را پیش و پس از انتشار بررسی کنید. Article، Breadcrumb، Organization و در صورت انطباق واقعی LocalBusiness از نوعهای متداول سایت شرکتیاند. Schema ساختگی برای Rating، FAQ یا Review میتواند بهجای کمک، ریسک ایجاد کند.
برای اینکه محتوا در جستوجوهای مبتنی بر پاسخ و موتورهای هوش مصنوعی نیز قابل فهمتر باشد، مقاله آینده GEO و AEO؛ سئو برای ChatGPT و AI Overviews ارتباط ساختار محتوا، Entity و پاسخ مستقیم را بررسی میکند.
۱۲. امنیت و سلامت سایت را بررسی کنید
HTTPS معتبر، Redirect یکپارچه به نسخه امن، نبود Mixed Content، Headerهای مناسب و بهروزبودن CMS و Dependencyها بخشی از سلامت فنیاند. هک میتواند صفحه Spam، Redirect مخفی یا محتوای تزریقشده بسازد و اعتماد کاربر و حضور در جستوجو را آسیب بزند.
Security Issues، Manual Actions، تغییر ناگهانی URLهای Indexشده و Log سرور را کنترل کنید. اگر نشانه مشکوک دیده میشود، راهنمای نشانههای هک شدن سایت مسیر بررسی اولیه را تکمیل میکند.
مرز Technical SEO و On-page SEO کجاست؟
Technical SEO بیشتر به دسترسی، پردازش و ساختار میپردازد؛ On-page SEO بر محتوا و نشانههای داخل صفحه تمرکز دارد. Title، Meta Description، Heading، Alt، URL و Internal Link در مرز این دو قرار میگیرند. صفحهای که ایندکس میشود ولی Intent را پاسخ نمیدهد با تغییر robots.txt رتبه نمیگیرد.
پس از رفع موانع Crawl و Index، کیفیت صفحه را با چکلیست سئوی داخلی صفحه بررسی کنید. بهتر است تیم محتوا و توسعه یک Definition of Done مشترک داشته باشند تا خطا هنگام انتشار دوباره تولید نشود.
مثال عملی: افت ورودی پس از بازطراحی سایت شرکتی
فرض کنید یک شرکت سایت جدید خود را منتشر کرده و دو هفته بعد Impression صفحات خدمات کاهش یافته است. Crawl نشان میدهد URLهای قدیمی به صفحه اصلی Redirect شدهاند، برخی صفحات جدید Canonical را به آدرس Staging میفرستند و منوی موبایل فقط با رویداد JavaScript ساخته میشود؛ بنابراین لینکهای خدمات در HTML Renderشده کامل نیستند.
اولویت نخست، حذف Canonical اشتباه و ساخت Mapping یکبهیک Redirectهاست، چون مستقیماً صفحات درآمدزا را متاثر میکند. سپس لینکهای موبایل به href استاندارد تبدیل، Sitemap با URLهای نهایی بازسازی و لینک داخلی به صفحات جدید اصلاح میشود. Request Indexing فقط برای چند URL حیاتی پس از رفع علت استفاده میشود.
موفقیت با «صفرشدن خطای ابزار Crawl» سنجیده نمیشود. Google-selected canonical، تعداد صفحات خدمت Indexشده، Impression Queryهای هدف، Click و Conversion فرم در بازه مناسب پایش میشوند. بازگشت سیگنالها ممکن است زمان ببرد؛ بنابراین زمان تغییر و Annotation دقیق ضروری است.
چگونه خطاهای سئوی فنی را اولویتبندی کنیم؟
گزارشهای Crawl معمولاً صدها هشدار میسازند. هر هشدار مسئله تجاری نیست. برای اولویت از چهار عامل استفاده کنید:
- Impact: خطا مانع Crawl، Index، Ranking یا Conversion میشود؟
- Reach: چند URL و کدام Template را متاثر میکند؟
- Business Value: صفحات متاثر خدمت، سرنخ یا درآمد ایجاد میکنند؟
- Effort و Risk: اصلاح چقدر زمان میبرد و احتمال اثر جانبی آن چیست؟
یک noindex روی تمام صفحات خدمت بحرانی است؛ ۲۰۰ Title طولانی در صفحات کماهمیت ممکن است متوسط باشد. Quick Winها را اجرا کنید، اما برای مشکل Template یا معماری Root Cause را حل کنید. هر Ticket باید نمونه URL، رفتار فعلی، رفتار مطلوب، معیار پذیرش و روش QA داشته باشد.
چکلیست فنی ویژه سایت شرکتی
- تنها یک نسخه اصلی دامنه با HTTPS در دسترس است و نسخههای دیگر Redirect میشوند.
- صفحات خدمت، درباره ما، تماس و شعب پاسخ 200 و Self-canonical درست دارند.
- صفحه تشکر، پنل، Search داخلی و محیط آزمایشی سیاست Index مشخص دارند.
- robots.txt منابع ضروری Render و صفحات تجاری را مسدود نمیکند.
- Sitemap فقط URLهای Canonical و Indexable را فهرست میکند.
- منو و Footer به خدمات اصلی با لینک HTML استاندارد متصلاند.
- صفحه یتیم، Redirect Chain و Broken Internal Link برای URLهای مهم وجود ندارد.
- Title، H1، Description و محتوای نسخه موبایل با Desktop هممعنا هستند.
- Organization، Breadcrumb و Article Schema در صورت ارتباط معتبرند.
- نام، آدرس و اطلاعات تماس در سایت و پروفایلهای اصلی سازگارند.
- LCP، INP و CLS بر اساس Field Data و Template پایش میشوند.
- Search Console، Analytics و Conversionهای واقعی بهدرستی متصلاند.
- Backup، Monitoring، Security Update و برنامه واکنش به رخداد تعریف شدهاند.
اشتباههای رایج در سئوی فنی
برابرگرفتن Crawl با Index
گزارش 200 ابزار Crawl نشان نمیدهد صفحه در Index گوگل است. URL Inspection و گزارش Page Indexing را در کنار Crawl داخلی ببینید.
استفاده از robots.txt برای حذف نتیجه
Disallow مانع درخواست محتوا میشود، اما URL ممکن است همچنان شناخته شود. روش کنترل Index را متناسب با هدف انتخاب کنید.
Canonical به همهچیز
Canonical صفحه نامرتبط را جایگزین کیفیت پایین نمیکند. نسخهها باید واقعاً Duplicate یا بسیار مشابه باشند و سیگنالها تعارض نداشته باشند.
تمرکز روی امتیاز ابزار
امتیاز ۱۰۰ Lighthouse یا Health Score بالا هدف تجاری نیست. اثر بر Templateهای مهم و کاربران واقعی را بسنجید.
اصلاح Production بدون QA
تغییر Redirect، robots یا Canonical دامنه وسیعی دارد. قبل از انتشار در محیط کنترلشده تست و پس از انتشار با نمونه URL و Monitoring بررسی کنید.
برنامه پایش پس از ممیزی
- خطاها را به Ticketهای قابل تست با Owner و Deadline تبدیل کنید.
- برای تغییرهای پرریسک، Backup، Rollback و نمونه Test URL داشته باشید.
- پس از Deploy، Header، HTML اولیه و Rendered HTML را کنترل کنید.
- Search Console، Server Log و Analytics را برای اثر مثبت و منفی پایش کنید.
- روزانه خطاهای بحرانی، هفتگی تغییر Index و ماهانه Templateها را مرور کنید.
- پس از تغییر CMS، دامنه، Navigation یا JavaScript یک Audit هدفمند تکرار کنید.
جمعبندی
سئوی فنی پایه قابلکشف و قابلفهمبودن سایت است. robots.txt، Status Code، Canonical، Sitemap، لینک داخلی، Render، موبایل، Performance، Schema و امنیت باید بهعنوان یک سیستم هماهنگ کار کنند. رفع هشدار پراکنده بدون توجه به صفحات مهم و هدف کسبوکار، زمان تیم را مصرف میکند اما الزاماً ورودی ایجاد نمیکند.
ممیزی را با Baseline و نمونه URLهای تجاری شروع کنید، تفاوت Crawl و Index را در تشخیص حفظ کنید، خطاها را بر اساس Impact و Reach اولویت دهید و نتیجه را پس از Deploy با داده واقعی بسنجید. Technical SEO یک پروژه یکباره نیست؛ کنترل کیفیت مستمر زیرساخت و انتشار است.
برای ممیزی فنی، اصلاح معماری، بهبود عملکرد و توسعه سایتی که از ابتدا برای Crawl و Index درست طراحی شده باشد، صفحه خدمات طراحی و توسعه وب و فروشگاه اینترنتی را ببینید. نقطه شروع مناسب، بررسی URLهای تجاری و پیدا کردن موانع با بیشترین اثر است.
منابع و مطالعه بیشتر
- Google Search Central: SEO Starter Guide
- Google Search Central: Crawling and Indexing
- Google Search Central: Introduction to robots.txt
- Google Search Central: Canonicalization
- Google Search Central: Build and submit a sitemap
- Google Search Central: JavaScript SEO basics
- Google Search Central: Core Web Vitals
- Google Search Central: Introduction to structured data